零代码编程:用ChatGPT批量下载Lex Fridman播客字幕文本

GPT 如何决定调用工具:tool-call 模型与描述的作用 本文系统阐述了ChatGPT Apps中tool-call机制的核心原理与设计要点。传统Web应用依赖显式事件触发,而tool-call将决策权交予模型:用户输入后,模型自主判断是否调用工具,并生成结构化请求。关键在于工具的名称、描述与参数模式——它们构成模型“理解”和“使用”工具的唯一依据。优秀描述需明确适用场景、边界条件与参数含义,避免模糊或过度限定。工具命名应语义清晰(如suggest_gifts而非tool1),参数模式不仅是校验工具,更是引导模型正确提取信息的提示词。同时,权限标注(如destru 阅读详情

之前文章《零代码编程:用ChatGPT下载lexfridman的所有播客音频和文本》已经说明了Lex Fridman播客和字幕的下载方法。另外,这个网站https://karpathy.ai/lexicap/也有lexfridman播客的字幕文件。如何进行批量下载呢?
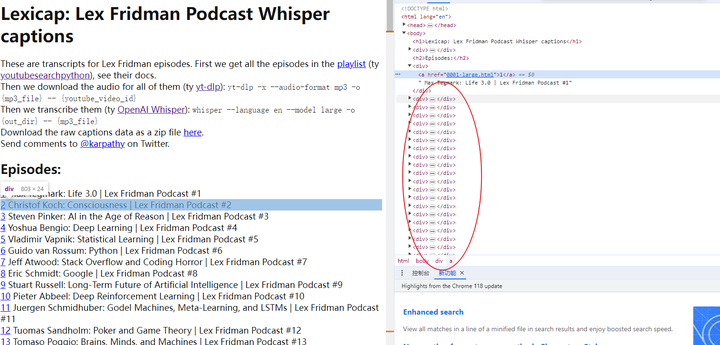
查看网页源代码,可以看到所有的字幕网页都在div标签中
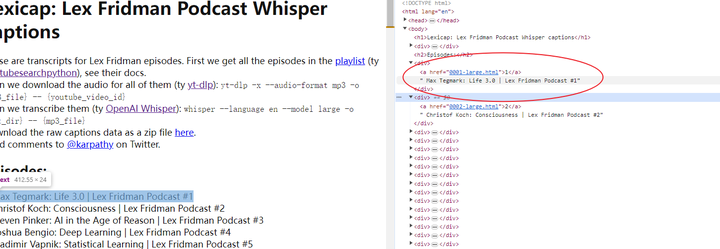
相关源代码如下:

<div><a href="0001-large.html">1</a> Max Tegmark: Life 3.0 | Lex Fridman Podcast #1</div>

打开后的网页地址是:https://karpathy.ai/lexicap/0018-large.html

因此,在ChatGPT中输入提示词:

你是一个Python编程专家,要完成批量下载网页的任务,具体步骤如下:

打开网站https://karpathy.ai/lexicap/,解析源代码;

定位所有div标签;

在div标签中定位a标签,提取其href值,前面加上:https://karpathy.ai/lexicap/,作为网页的下载地址;

提取div标签内容,然后将其中的特殊符号“:\ / : * ? " < > |,”改成“-”,作为网页的标题名称;

下载网页,保存到D:\lexfridman-podcast

注意:每一步都要输出相关信息

如果网页下载中出现错误,就跳过,继续下载下一个;
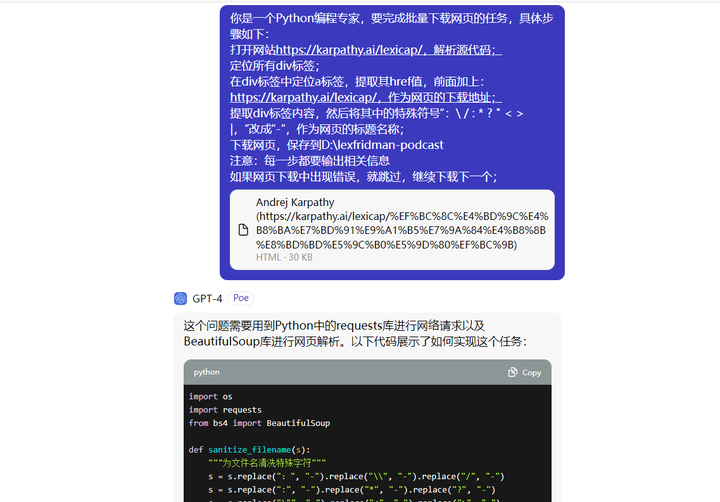
源代码:

import os

import requests

from bs4 import BeautifulSoup

def sanitize_filename(s):

"""为文件名清洗特殊字符"""

s = s.replace(":", "-").replace("\\", "-").replace("/", "-")

s = s.replace(":", "-").replace("*", "-").replace("?", "-")

s = s.replace("\"", "-").replace("<", "-").replace(">", "-")

return s.replace("|", "-")

# 打开网站并解析源代码

url = 'https://karpathy.ai/lexicap/'

print(f"访问网站: {url}")

res = requests.get(url)

res.raise_for_status()

soup = BeautifulSoup(res.text, 'html.parser')

# 定位所有div标签

div_tags = soup.find_all('div')

print(f"找到 {len(div_tags)} 个div标签")

# 创建存储文件夹

save_dir = "D:\\lexfridman-podcast"

os.makedirs(save_dir, exist_ok=True)

# 在div标签中定位a标签,提取其href值,前面加上:https://karpathy.ai/lexicap/,作为网页的下载地址;

for div in div_tags:

a_tags = div.find_all('a')

for a in a_tags:

href = a.get('href')

if href:

download_url = 'https://karpathy.ai/lexicap/' + href

# 提取div标签内容,然后将其中的特殊符号“:\ / : * ? " < > |,”改成“-”,作为网页的标题名称;

filename = sanitize_filename(div.text) + '.html'

filename = os.path.join(save_dir, filename)

# 下载网页,保存到D:\\lexfridman-podcast

print(f"下载 {download_url} 到 {filename}")

try:

res = requests.get(download_url)

res.raise_for_status()

with open(filename, 'w', encoding='utf-8') as f:

f.write(res.text)

except Exception as e:

# 如果网页下载中出现错误,就跳过,继续下载下一个;

print(f"下载 {download_url} 时出现错误: {e}")

Continue
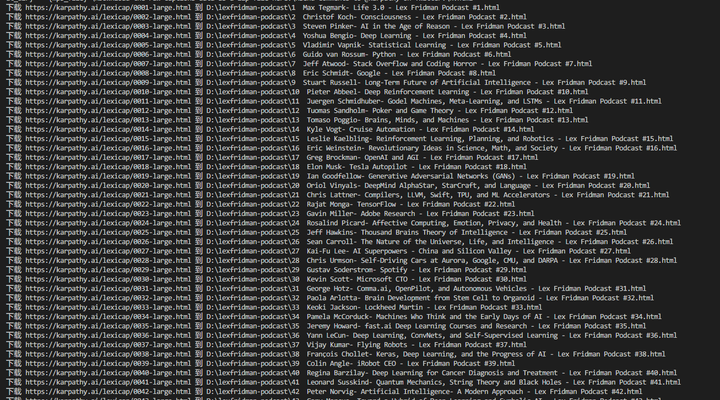
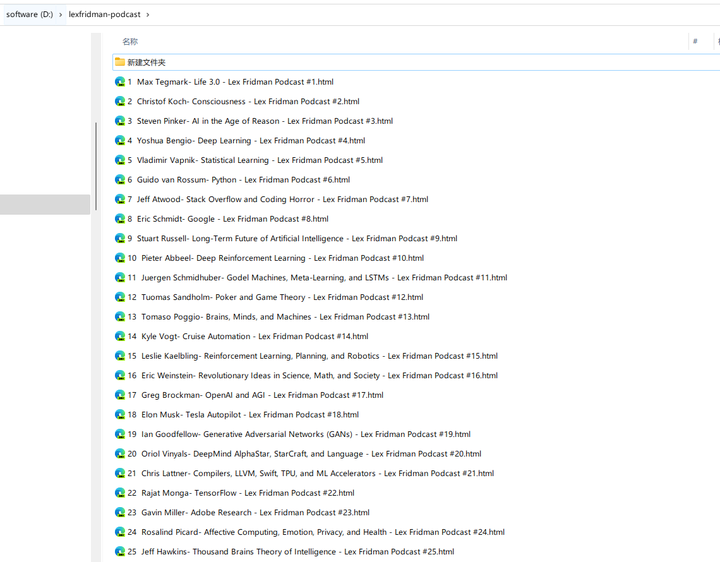
所有播客字幕文件下载完成:
ChatGPT5.2_Codex_零基础图文手册 ChatGPT5.2_Codex_零基础图文手册》面向首次接触 Codex 及 AI 编程工具的初学者,以“看得懂、能操作、可复现”为主要目标,通过图文结合的方式,对 Codex 的基础使用流程、环境准备、任务交互、代码理解、修改调试及常见问题处理进行系统梳理。文章尽量减少复杂术语和默认前置知识,以真实操作场景为主线,帮助读者逐步建立 AI 辅助编程的基本方法与使用习惯。希望通过这份手册,让更多没有专业编程背景的用户,也能够理解 Codex、使用 Codex,并尝试借助 AI 完成自己的第一个实际开发任务 阅读详情

相关推荐

2026年9月11日|ChatGPT Pro + GPT‑6 Astra:Codex 内部开发平台实战

当团队真正进入 AI 编程阶段,最高效的做法往往不是给每个人更多 Prompt,而是给人和 AI 同一套正确路径。ChatGPT Pro 可以用于持续设计平台能力,GPT‑6 Astra 处理复杂计划和跨系统推理,Codex 维护真实 CLI、模板与仓库。标准命令标准模板标准验证标准权限标准审计AI 产出才更容易稳定进入团队工程体系。

2601_96445177的博客 366

AI与大模型新闻日报 | 2026-09-09

IT之家 9 月 9 日消息,任天堂与索尼影业基于《塞尔达传说》IP 合作打造的真人电影已经完成拍摄,正在后期制作中。任天堂官方昨晚宣布,这部电影片名正式确认为《塞尔达传说》,无副标题。今年 5 月,任天堂官方宣布将这部电影全球影院上映日期从 2027 年 5 月 7 日提前为 2027 年 4 月 30 日。官方对剧情保持高度保密,仅公布了由本杰明 · 埃文 · 安斯沃思(Benjamin Evan Ainsworth)饰演林克、博 · 布拉加森(Bo Bragason)饰演塞尔达的剧照。

dozenyaoyida的博客 148

深入理解人工智能 chatGPT的软件架构

ChatGPT是一个复杂的系统,其软件架构可以清晰地划分为几个核心的功能模块,它们协同工作以提供流畅、智能的对话体验。这些模块的交互流程,可以理解为用户请求从进入到响应返回所经过的一条“流水线”。

m0_73457176的博客 223

ChatGPT5.2_Codex_零基础图文手册(正文 一)

零基础学员应优先通过CodexIDE扩展入门,结合VSCode等编辑器直观体验任务执行流程。掌握“任务、边界、验证、审批、回退”五步法,从解释项目、修复小bug等低风险任务开始,逐步建立信心。建议使用ChatGPT账号登录,准备可回退的练习仓库,并学会创建Git检查点。避免直接进入CLI或复杂配置,以降低学习门槛。本文档聚焦新手痛点,强调结构化引导与即时反馈,助力首次上机即成功。

qq_42963695的博客 151

ChatGPT整理SOP总是步骤不完整?流程拆解、输入输出与异常情况整理方法

ChatGPT整理SOP时为什么经常步骤太粗、异常情况缺失?本文从流程拆解、输入输出、前置条件、完成标准和异常处理等方面,整理把零散经验转成可执行SOP的方法。

L773014954的博客 372

ChatGPT怎么用?2026年完整使用教程:从基础提问到文件分析、Deep Research与AI工作流

所以,“ChatGPT怎么用”这个问题真正的答案,并不是学会几个所谓的“万能提示词”。明确目标↓提供上下文↓规定约束↓定义输出↓选择工具↓验证结果↓继续迭代如果只记住一句话,可以记住:不要只告诉 ChatGPT“你想问什么”,而要告诉它“你最终想完成什么”。ChatGPT 正逐渐从一个聊天机器人变成 AI 工作平台。会不会设计 AI 工作流。

2601_96535568的博客 242

2026年9月9日|ChatGPT Pro + Codex:GPT‑6 Astra Agent 开发实战

GPT‑6 Astra + Codex 最值得研究的方向之一,就是 Agent。但专业 Agent 并不是让模型获得最大自由,而是给它足够能力完成任务,同时让系统始终知道它能做什么、正在做什么、什么时候必须停。对于重度 Agent 开发者,我更倾向 Pro,因为真正的 Agent 项目会频繁触发多轮模型与工具交互,Work / Codex 的持续使用能力比单次聊天上限更重要。模型越来越强之后,最有价值的开发能力反而会回到软件工程本身:边界、验证、状态和责任。

dunge2026的博客 341

ChatGPT Images2.5 全面开放

ChatGPT Images 2.5 是一版"工程化"浓度很高的发布:性能上把延迟最多砍半,产品上把多轮编辑和局部圈改做实,生态上通过 Flare/Sunburst 双模型把"速度"和"精度"拆成两个可独立定价的能力,同时全层级开放含免费版。配合每周 30 亿张图的规模,OpenAI 显然在把生图往"基础设施"的位置上推。延迟降 50% 是官方自报,独立基准尚未出来;Flare/Sunburst 的 token 消耗未公开,实际单图成本需要自己压测,别被 $30/百万 的 token 价带偏;

CSDNzhizunbao的博客 483

GPT-6 Astra 在 Plus 订阅中不显示的原因及 Chat、Work、Codex 入口差异解析

ChatGPT Plus 看不到 GPT-6 Astra,先检查自己是否在普通 Chat 里寻找 GPT-6 Pro。官方把 Plus 的 Astra 权限列在 Work 和 Codex,并说明各入口逐步开放。对 Plus 用户,套餐包含 Astra 与当前页面出现模型选项,不能直接画等号。本文按入口、账号和客户端给出排查顺序。核对日期:2026 年 9 月 8 日。开放范围可能变化,以账号实际显示及文内官方页面为准。

ofoxcoding的博客 217

2026年9月9日|ChatGPT Pro + Codex:GPT‑6 Astra 全栈开发实战

GPT‑6 Astra + Codex 最值得关注的地方,不是让 AI 替代程序员,而是让一个开发者可以同时拥有需求分析助手、架构审查助手、仓库级编码代理、自动测试执行者、Debug 协作者和文档整理工具。偶尔写代码,Plus 已经很有价值;但如果每天都在 Codex、Work、复杂项目和长任务之间反复切换,Pro 的完整 Astra 使用空间更容易真正转化为生产力。未来开发者之间的差距,很可能不再是“会不会问 AI”,而是“能不能把 AI 放进一个有边界、有测试、有版本控制的工程系统里持续工作”。

dr_eric123的博客 411

2026年9月11日|ChatGPT Pro + Codex:GPT‑6 Astra 数据库性能优化

数据库性能不是 SQL 写得漂亮就够了。真实查询真实执行计划真实数据规模真实基准GPT‑6 Astra 能帮助理解复杂执行路径,Codex 能把修改落到代码、测试和 migration,但最终必须让数据库自己给出证据。对重度后端开发者来说,这也是 Pro 工作流比单纯聊天更有价值的地方。

dunge2026的博客 162

深入理解人工智能 chatGPT的客户端与接入层 (Client & Access Layer)

**第三方集成**:通过 **Apps SDK** 和 **Model Context Protocol (MCP)**,ChatGPT 可以作为一个“宿主”环境,在其中运行第三方开发者构建的交互式应用(Widget)。* **用户认证**:对于普通用户,接入层会集成 **OAuth 2.0 / OIDC** 等标准协议,并支持企业级的 **SSO**。接入层是请求进入 OpenAI 后端基础设施的第一站,扮演着**流量警察**、**认证中心**和**调度员**的多重角色。

m0_73457176的博客 158

ChatGPT怎么用得更专业?Prompt工程、API调用与AI Agent工作流实战

..缺少参数,函数自然无法工作。Prompt 同样如此。Task:代码审查Input:Python代码Goal:降低P99延迟不改数据库Output:问题列表 + 优先级 + 修改建议这就是一种非常接近结构化接口的思维。输出格式不可预测。经过综合分析,我认为风险比较高……人能看懂。程序不好解析。即结构化输出。仅输出JSON:这样后续程序才能继续处理。RAG检索增强生成用户问题↓向量化↓搜索知识库↓找到相关文档↓把文档加入Context↓LLM生成答案。

2601_96535568的博客 210

ChatGPT到GPT‑6 Astra:当AI开始解数学难题、自主操作软件

9 月 3 日凌晨,我正刷手机准备睡觉,OpenAI 突然甩出一个重磅炸弹——GPT-6 Astra,说发就发,连个预告都没有。翻译成人话:欢迎来到 AGI 时代。再翻译成程序员的话:写代码的,注意点。AI 的角色变了:从"你问它答"变成"你说它做",白领工作的定义正在被改写。研究的范式变了:AI 开始产出人类没有的新知识,科研本身成为可自动化的工作流。人类文明史上头一次。迭代的闭环出现了:前代模型监督训练后代模型,飞轮开始转。如果真转起来,进步速度不可预测。

人工智能AI技术 428

2026年9月11日|ChatGPT Pro + Codex:GPT‑6 Astra RAG 知识库实战

能找到相关资料能区分新旧版本能引用证据证据不足时会停止权限不允许时根本检索不到内容如果只追求“回答流畅”,系统很快会出现一种危险状态:听起来合理,却无法确认答案到底来自哪份文件。不要让模型自己生成一个“93% 置信度”然后把它当统计学概率。更实用的是这种可执行状态。RAG 进入 GPT‑6 时代以后,重点已经不是有没有向量数据库,而是有没有一套可靠的知识工程系统。ChatGPT Pro:长期需求与评估设计Codex:维护检索、索引和测试代码GPT‑6 Astra:查询改写与复杂证据推理。

dr_eric123的博客 567

2026年9月8日|ChatGPT Pro + Codex:用 GPT‑6 Astra 重做自动化测试

GPT‑6 Astra 和 Codex 带来的真正变化,不是“以后不用写测试”。恰恰相反。AI 让我们第一次有机会低成本地把更多精力放到失败模式、边界条件、回归风险、副作用、并发和兼容性这些过去经常因为时间不够而被忽略的部分。先分析,再实现;先测试,再相信;测试失败先定位,不要直接改;最终用 diff 和确定性工具验收。当 GPT6 进入软件工程之后,这种工作方式比任何单条“神级提示词”都更重要。

dunge2026的博客 392

深入理解人工智能 chatGPT的安全与合规层 (Safety & Moderation Layer)

**Moderation API 与风险分类**:OpenAI提供了免费的Moderation API,可将内容分类为**13个有害类别**,包括仇恨、骚扰、自残、性内容、暴力等,并支持对子类别(如 `self-harm/intent`)的精细识别。* **对抗性绕过**:红队研究显示,现有的安全护栏仍可被精心设计的**提示注入**、**跨语言攻击**、**角色扮演**等手段绕过,暴露出当前基准测试在评估真实风险方面的局限性。如何精准区分“合法研究”与“恶意滥用”,是持续的技术与伦理难题。

m0_73457176的博客 184

【OpenAI 昨天正式更新了 ChatGPT Images 2.5。】

OpenAI发布ChatGPT Images 2.5,核心升级不再只是画质,而是让AI生图成为可迭代的视觉创作工具:显著提升参考图保真与多轮编辑一致性,生成速度最高提升50%,新增草图转图、模板化、图片局部评论修改和Prompt分享功能,并发布Flare与Sunburst两款API模型。这标志着AI生图从“Prompt→图像”转向“想法→草图/参考→生成→迭代→成品”的工作流,本质更像AI视觉代理,未来关键是清楚表达需求。

Xu_youyaxianshen的博客 223
上一篇: 零代码编程:用ChatGPT将vtt转换成LRC和srt格式的字幕
下一篇: 零代码编程:用ChatGPT进行批量重命名时需要注意特殊字符
AIGCTribe
博客等级 码龄3年 2365粉丝 417原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

红包个数最小为10个

红包金额最低5元

当前余额3.43前往充值 >
需支付:10.00
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值